AI-bots en robots.txt: zo bepaal je welke AI-crawlers je site mogen lezen
20 oktober 2026
Wij helpen bedrijven groeien met AI-gedreven marketing.
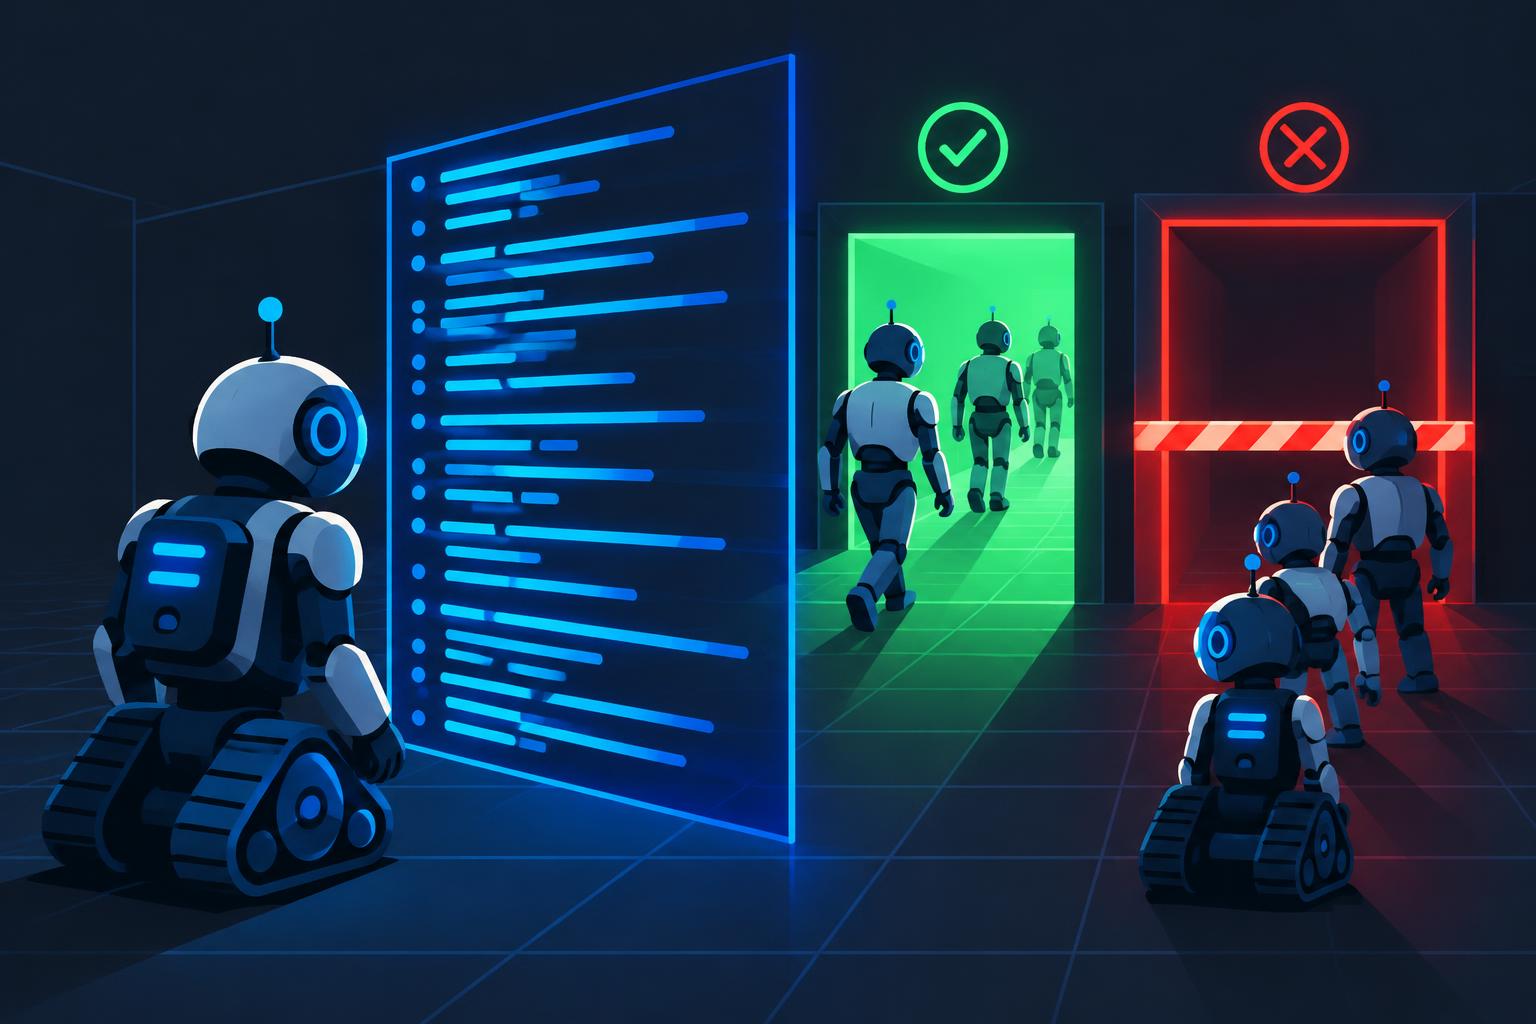
AI-bots bezoeken je website vaker dan je denkt. Crawlers van OpenAI, Anthropic, Perplexity en Google lezen je pagina's om modellen te trainen of om live antwoorden te geven aan gebruikers. Met je robots.txt-bestand bepaal je welke van deze bots welkom zijn en welke niet. Die keuze heeft directe gevolgen voor je zichtbaarheid in AI-antwoorden — en dus voor je vindbaarheid morgen. In dit artikel lees je welke AI-bots er zijn, wat blokkeren betekent voor je GEO-strategie en hoe je robots.txt stap voor stap goed instelt.
Wat doet robots.txt ook alweer?
Robots.txt is een simpel tekstbestand in de hoofdmap van je website (bijvoorbeeld jouwsite.nl/robots.txt). Daarin leg je per bot vast welke delen van je site die wel of niet mag bezoeken. Het bestand werkt met twee eenvoudige regels: User-agent (de naam van de bot) en Disallow of Allow (wat die bot wel of niet mag lezen).
Belangrijk om te weten: robots.txt is een verzoek, geen slot op de deur. Nette crawlers van grote partijen houden zich eraan. Kwaadwillende scrapers negeren het bestand gewoon. Wil je echt afschermen, dan heb je een wachtwoord, paywall of blokkade op serverniveau nodig.
Welke AI-bots zijn er?
Er zijn grofweg drie soorten AI-crawlers, en het verschil is belangrijk voor je strategie:
- Trainingscrawlers verzamelen content om taalmodellen mee te trainen. Voorbeelden: GPTBot (OpenAI), ClaudeBot (Anthropic) en CCBot (Common Crawl, waar veel modellen indirect van leren).
- Zoek- en antwoordcrawlers halen content op om nu een antwoord te geven aan een gebruiker, vaak met een bronvermelding. Voorbeelden: OAI-SearchBot en ChatGPT-User (OpenAI), PerplexityBot (Perplexity) en de crawlers achter Google AI Overviews en AI Mode.
- Klassieke zoekmachinecrawlers zoals Googlebot en Bingbot, die je site indexeren voor de traditionele zoekresultaten — en bij Google ook voeden wat AI Overviews kan tonen.
Overzicht: de belangrijkste AI-bots in 2026
| Bot | Van | Doel | Blokkeren betekent |
|---|---|---|---|
| GPTBot | OpenAI | Trainen van modellen | Je content leert het model minder goed kennen |
| OAI-SearchBot | OpenAI | Index voor ChatGPT-zoekresultaten | Minder kans op vermelding in ChatGPT-antwoorden |
| ChatGPT-User | OpenAI | Live ophalen bij een concrete vraag | ChatGPT kan je pagina niet citeren in antwoorden |
| ClaudeBot | Anthropic | Trainen en antwoorden van Claude | Minder zichtbaarheid in Claude |
| PerplexityBot | Perplexity | Antwoorden met bronvermelding | Perplexity kan je niet als bron tonen |
| Google-Extended | Training van Gemini | Geen invloed op je Google-rankings, wél op training | |
| Googlebot | Index voor Search én AI Overviews | Je verdwijnt uit Google — vrijwel nooit verstandig | |
| Applebot | Apple | Siri- en Spotlight-antwoorden | Minder zichtbaarheid in Apple-ecosysteem |
Let op het verschil tussen Google-Extended en Googlebot: met Google-Extended blokkeer je alleen het trainen van Gemini, niet je vindbaarheid in Google. Googlebot daarentegen blokkeren betekent dat je uit de zoekresultaten verdwijnt. Behandel die twee dus nooit hetzelfde.
Voorbeeld: zo ziet een doordachte robots.txt eruit
Stel: je wilt graag gevonden worden in AI-antwoorden, maar je wilt niet dat je content wordt gebruikt om modellen mee te trainen. Dan zou je bestand er zo uit kunnen zien:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Allow: /
Hiermee blokkeer je de trainingscrawlers, maar blijf je zichtbaar voor de zoek- en antwoordbots die je verkeer en vermeldingen kunnen opleveren. Wil je juist maximale zichtbaarheid? Dan laat je alles open en voeg je eventueel een llms.txt-bestand toe als vriendelijke wegwijzer voor AI-systemen.
Blokkeren of toestaan: wat is verstandig voor jou?
Er is geen eensluitend antwoord — het hangt af van je verdienmodel:
- Je verdient aan bereik, leads of advertenties: laat de antwoordbots binnen. Elke vermelding in ChatGPT, Perplexity of AI Overviews is gratis zichtbaarheid. Blokkeren betekent dat concurrenten die bronpositie overnemen.
- Je content ís het product (bijvoorbeeld een betaald archief of databank): overweeg trainingscrawlers te blokkeren en alleen antwoordbots toe te laten, zodat je wel vermeld wordt maar je content niet gratis in modellen verdwijnt.
- Je maakt je zorgen over serverbelasting: sommige AI-crawlers bezoeken sites intensief. Beperk dan liever gericht (per bot of per map) dan alles dicht te gooien.
Wat we in de praktijk vaak zien: sites blokkeren per ongeluk meer dan bedoeld. Een generieke regel die ooit is neergezet tegen "alle bots" kan ook AI-antwoordbots uitsluiten — en dan ben je onzichtbaar in precies de kanalen waar je wilt groeien. Controleer je bestand dus minstens één keer per kwartaal.
Stappenplan: je robots.txt AI-proof maken
- Bekijk je huidige bestand. Ga naar jouwdomein.nl/robots.txt en noteer welke regels er staan.
- Check je serverlogs of analytics. Welke AI-bots bezoeken je site al? Herken je GPTBot, ClaudeBot of PerplexityBot in de logs?
- Bepaal je strategie per bottype. Trainingscrawlers, antwoordcrawlers en zoekmachines vragen elk een eigen keuze.
- Schrijf de regels expliciet uit. Vermijd vage wildcard-regels; benoem de belangrijke bots bij naam.
- Test na publicatie. Controleer of het bestand live staat en of je niet per ongeluk je hele site hebt afgesloten.
- Meet het effect. Houd bij of je vermeld wordt in AI-antwoorden. Onze gratis GEO- en SEO-scan geeft je een eerste indicatie van je AI-zichtbaarheid.
Veelgemaakte fouten
- Alles blokkeren uit voorzorg. Daarmee geef je je positie in AI-antwoorden weg aan concurrenten die wél meedoen.
- Robots.txt verwarren met beveiliging. Gevoelige pagina's beveilig je met inlog, niet met een Disallow-regel — die is juist een hint dat er iets te halen valt.
- Vergeten dat robots.txt geen indexatie blokkeert. Een pagina die geblokkeerd is voor crawlers kan alsnog in zoekresultaten verschijnen (zonder beschrijving). Gebruik noindex als je dat wilt voorkomen.
- Nooit meer updaten. Nieuwe bots verschijnen continu; een bestand uit 2023 kent de huidige AI-crawlers niet.
Veelgestelde vragen
Blokkeer ik met robots.txt ook AI Overviews van Google?
Alleen als je Googlebot blokkeert — en dan verdwijn je ook uit de gewone zoekresultaten. Google-Extended blokkeren heeft géén invloed op AI Overviews of je rankings; het stopt alleen het gebruik van je content voor het trainen van Gemini.
Is het verstandig om GPTBot te blokkeren?
Dat hangt van je doel af. GPTBot traint modellen; blokkeren betekent dat ChatGPT jouw merk minder goed leert kennen. Wil je zichtbaar blijven in antwoorden maar niet meehelpen aan training, blokkeer dan GPTBot en laat OAI-SearchBot en ChatGPT-User toe.
Houden AI-bots zich wel aan robots.txt?
De grote partijen (OpenAI, Anthropic, Google, Perplexity) verklaren dat te doen. Onbekende scrapers negeren het bestand vaak. Robots.txt is dus een stuurinstrument, geen beveiliging.
Hoe vaak moet ik mijn robots.txt controleren?
Minimaal één keer per kwartaal, en altijd na een website-migratie of redesign. Nieuwe AI-bots verschijnen regelmatig, dus werk je lijst met toegestane en geblokkeerde bots periodiek bij.
Wat is het verschil tussen robots.txt en llms.txt?
Robots.txt regelt wie je site mág lezen; llms.txt legt uit wat er op je site te vinden is. Ze vullen elkaar aan: de eerste is de portier, de tweede de gastheer.
Kan ik per pagina verschillende regels instellen?
Ja, met Disallow- en Allow-regels op padniveau (bijvoorbeeld alleen /blog/ toestaan). Voor fijnmazige controle per pagina gebruik je daarnaast meta-tags zoals noindex en nosnippet.
Conclusie
Robots.txt is in het AI-tijdperk veranderd van een technisch detail naar een strategische keuze. Wie doordacht bepaalt welke AI-bots welkom zijn, houdt grip op waar zijn content verschijnt — en waar niet. Begin met een eenvoudige controle van je huidige bestand, kies per bottype een richting en meet vervolgens of je zichtbaarheid in AI-antwoorden groeit. Wil je weten hoe jouw site er nu voorstaat? Doe de gratis GEO- en SEO-scan of lees hoe ons AI marketing bureau je helpt met een complete GEO-aanpak.
Vrijblijvend advies over AI-bots en robots.txt: zo bepaal je welke AI-crawlers je site mogen lezen
Laat je gegevens achter en we nemen binnen één werkdag contact met je op met een concreet voorstel.